
ICDE 2027 | Falcon:基于GPU的浮点数据自适应无损压缩框架
随着物联网、高性能计算和性能监控系统的快速发展,传感器监测、科学模拟、航空航天、金融分析和时序数据库等场景中产生了大量浮点数据。面对这类数据,压缩不仅需要保证解压后与原始数据完全一致,还需要尽可能提升压缩率,以减少存储与传输开销。与此同时,在大规模数据处理场景下,压缩系统还必须具备足够高的吞吐能力,才能避免成为整体系统的性能瓶颈。那么,能否借助 GPU 强大的并行计算能力,同时兼顾高压缩率与高吞吐?本次为大家带来重庆大学与蚂蚁集团OceanBase团队合作,在数据库领域顶级会议ICDE2027最新接收的文章《Falcon: GPU-Based Floating-point Adaptive Lossless Compression》。
一. 背景
现有无损压缩方法大致可以分为两类:一类是Gzip、Lz4等通用无损压缩算法,它们能够保证无损,但没有充分利用浮点数据自身的结构特征,压缩率往往有限;另一类是Elf、ALP、Camel、Kangaroo等面向浮点数据的专用无损压缩方法取得了更好的压缩效果,但大多依赖CPU实现,在处理海量数据时吞吐能力仍受限制。
GPU强大的并行计算能力为浮点数据压缩提供了新的加速可能。然而,GPU强在并行计算,并不意味着将现有CPU压缩算法直接迁移过去就能获得高性能。论文指出,面向GPU的浮点无损压缩主要面临三方面挑战。
(1)挑战1:CPU-GPU异构数据传输瓶颈:
在CPU–GPU协同压缩流程中,原始数据通常需要由CPU从外部存储读取,并通过PCIe传输到GPU;压缩完成后,结果还需要从GPU回传到CPU。由于压缩结果大小通常无法提前预测,系统不仅需要处理数据传输延迟,还需要解决显存分配和结果写入位置确定等问题。
(2)挑战2:浮点到整数的精确转换复杂:
许多浮点压缩方法会先将浮点数转换为整数。例如,1.02可以转换为102,并记录小数位数为2,解压时再恢复为1.02。但计算机浮点运算可能产生误差,例如1.11×10²在计算机中可能变为111.00000000000001,从而导致小数位判断错误,并进一步影响整个数据块的压缩效果。
(3)挑战 3:异常值导致稀疏性退化:
浮点数据中常常存在异常观测值,它们并非可以直接丢弃的错误数据,而是时间序列中显著不同于其他值的正常数据。经过整数转换后,这些异常值可能被进一步放大。如图1所示,7.15转换为7150后会成为明显的整数异常值,使整个数据块需要更宽的比特表示,从而产生大量无效前导零,降低压缩效率。
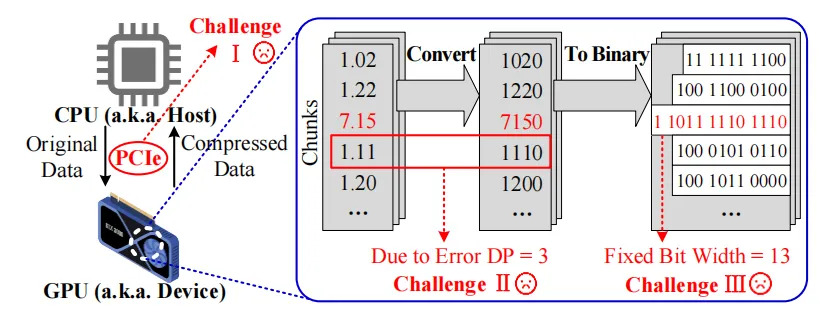
图1 基于GPU的浮点无损压缩面临的挑战
针对上述问题,Falcon分别提出三项核心设计:一是通过轻量级异步流水线隐藏CPU-GPU数据传输延迟;二是设计带理论保证的快速浮点到整数转换方法,避免浮点运算误差影响无损恢复;三是采用自适应稀疏位平面编码策略,在适应GPU并行执行模型的同时缓解异常值带来的压缩效率下降。
二. 方法介绍
2.1 总体框架
本文提出的Falcon框架主要由压缩(Compression)和解压(Decompression)两部分组成。其中,压缩模块负责将原始浮点数据转换为高效存储形式,解压模块则负责根据压缩结果恢复原始数据。
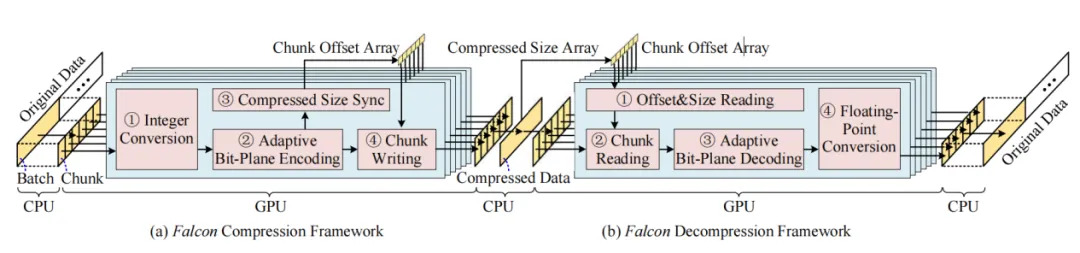
图2 Falcon 整体框架
2.1.1 压缩模块
如图2所示,Falcon 的压缩过程主要包括四个阶段:
(1)整数转换(IntegerConversion):首先,CPU将原始浮点数据读取为 batch,并通过PCIe传输至GPU。随后,数据划分为多个chunk,每个GPU线程负责处理一个chunk,并将浮点数据转换为更适合压缩的整数表示。
(2)自适应位平面编码(AdaptiveBit-PlaneEncoding):在完成整数转换后,Falcon进一步对整数数据进行编码,通过分析不同位平面的稀疏特征,自适应选择合适的存储方式,从而减少数据冗余并提升压缩率。
(3)压缩大小同步(CompressedSizeSync):由于不同chunk的压缩结果大小并不固定,Falcon需要同步各个chunk 的压缩大小,并计算对应的数据偏移位置,以保证压缩结果能够正确写入GPU全局内存。
(4)Chunk写入(ChunkWriting):最后,各线程根据计算得到的偏移位置,将压缩后的数据写入对应区域,并由CPU将压缩结果从GPU传回主存,完成整个压缩过程。
2.1.2 解压模块
解压过程是压缩过程的逆过程。系统根据压缩数据中的大小信息定位每个chunk,再由GPU线程并行完成位平面解码和逆整数转换,恢复原始浮点数据。由于解压后的数据大小固定且提前可知,Falcon在解压阶段采用预分配策略,以减少额外同步开销。
在上述整体框架基础上,Falcon进一步针对GPU压缩过程中的关键瓶颈设计了三个核心模块,下面将分别介绍Falcon的三个核心设计:异步流水线、浮点到整数转换和自适应位平面编码。
2.2 三个核心设计
2.2.1 异步流水线
在GPU压缩过程中,计算并不是唯一限制因素。由于原始数据需要通过PCIe 在CPU和GPU之间传输,而压缩结果大小又无法提前确定,这一过程容易带来显存浪费、数据写入冲突以及额外的数据搬移开销。
针对这一问题,Falcon设计了一种异步流水线机制,通过重叠数据传输和压缩计算,隐藏CPU-GPU之间的I/O延迟。如图3所示,该模块首先分析了两种较直接的调度策略:(1)Pre-AllocationScheduler:该方法提前为每个batch分配固定大小的显存空间,GPU完成压缩后直接写入对应位置。简单但会导致产生内存碎片,需要花费资源进行整理。(2)Sync-BasedScheduler:该方法将GPU到CPU的数据回传拆分为两个阶段:首先同步压缩结果大小,再传输实际压缩数据。同步压缩结果会导致整个流水线阻塞。
在此基础上,Falcon进一步提出基于GPU Event的事件驱动调度策略(Event-DrivenScheduler),如图3(c)所示。该策略将每个batch处理过程划分为Idle、MPend和PPend三种状态。分别表示空闲、等待压缩大小信息和等待实际压缩数据回传完成。
具体来说,当一个batch完成GPU压缩后,系统首先将压缩结果大小传回CPU,并通过GPU Event通知CPU。CPU收到事件后,按照batch的启动顺序确定压缩结果的存储位置,并启动实际压缩数据的异步回传。此时,CPU无需等待该batch的全部数据回传完成,就可以继续调度其他任务。
与此同时,其他batch可以进行数据上传或GPU压缩,使不同batch的数据传输与压缩计算尽可能重叠。例如,当上一批数据正在从GPU回传至CPU时,下一批数据可以同时向GPU传输,从而将原本需要等待的PCIe传输时间隐藏在其他批次的处理过程中。
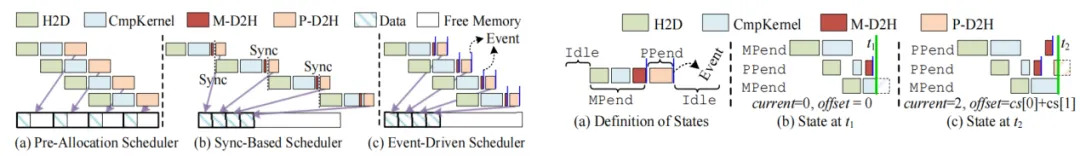
图3 不同流水线调度策略
简单来说,Falcon对流水线的优化并非依赖传统机制,而是通过GPU Event及时获取压缩结果大小,并利用异步调度机制协调不同batch的执行顺序,使数据上传、GPU压缩和结果回传能够重叠进行,从而提高GPU利用率并提升整体压缩吞吐。
2.2.2 浮点到整数转换
浮点数据直接进行压缩通常面临两个困难。
(1) IEEE 754标准定义的浮点数表示较为复杂,数值上的微小变化可能导致底层二进制表示发生明显变化;(2) GPU采用SIMT执行模型,复杂的逻辑判断会导致同一个 warp 内线程无法保持同步执行,从而降低并行效率。
因此,Falcon没有采用直接围绕浮点底层二进制位模式进行复杂逻辑处理的思路,而是采用更少分支判断的方案,先将浮点数转换为更容易压缩的整数,再进行GPU友好的编码。具体而言,对于浮点值,如果其小数位数为,Falcon 将其转换为:。例如,对于浮点数1.02,由于其小数位数为 2,因此可以转换为整数:102。在解压过程中,再通过:102÷102=1.02恢复原始浮点值。
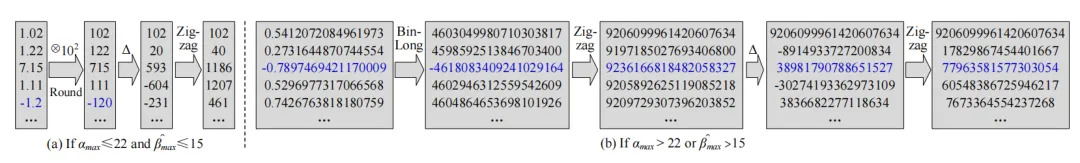
图4 浮点数到整数转换过程
然而,传统方法通常需要将浮点数转换为字符串,再通过字符串分析小数位数,计算开销较大;另一类方法通过不断尝试乘以10,判断结果是否接近整数,但容易受到浮点计算误差影响。例如,1.11的实际小数位数为2,但在计算机中,1.11×100可能得到111.00000000000001,而不是整数111。传统方法可能因此继续乘以10,最终错误地将小数位数判断。这种误判不仅增加了计算开销,还可能影响后续整数转换和压缩效果。
因此,Falcon需要解决两个关键问题:
问题1:如何快速准确计算浮点数的小数位数?
问题2:转换后的整数是否如何保证无损恢复?
针对小数位数计算容易受到浮点舍入误差影响的问题,Falcon提出了一种基于浮点误差界的快速计算方法。与传统方法直接判断缩放结果是否为整数不同,该方法从小数位数开始逐步尝试,计算浮点数乘以相应后与最近整数之间的差值,并判断该差值是否处于允许的浮点误差范围内。例如,对于浮点数1.11,当时,计算机可能得到111.00000000000001,但由于其与整数111之间的差值仍处于允许范围内,Falcon能够正确识别其小数位数。算法还通过逆向转换检查原始浮点值能否恢复,避免错误的转换结果。该方法具有理论正确性保证,最多进行15次循环判断,无需耗费较大的字符串解析开销。
然而,准确计算小数位数并不意味着所有浮点数都能直接通过十进制缩放实现无损转换。当数据的有效数字长度过大或小数位数过多时,即使进行了四舍五入,转换后的整数也可能无法准确还原原始浮点值。因此,Falcon进一步根据数据块的最大小数位数和缩放后的最大有效数字长度,选择不同的整数转换路径:对于满足无损转换条件的数据,采用十进制缩放转换;对于不满足条件的数据,则采用保留底层二进制信息的回退方案。两种转换路径如图4所示。
在准确计算小数位数后,Falcon 根据数据特征选择不同的整数转换方案。
如图4(a) 所示,对于每个数据块(chunk),Falcon首先确定其中所有浮点数的最大小数位数,并计算统一缩放后的最大有效数字长度。当满足 且时,采用十进制缩放转换:将数据块中的每个浮点数统一乘以,再通过四舍五入得到对应整数。例如,当时,浮点数1.02、1.22和1.11分别转换为整数102、122和111。随后,对相邻整数进行差分(Delta)计算,并使用Zigzag编码将差值转换为非负整数,使相邻数据之间的数值差异更小,从而提高后续编码效率。论文通过理论证明,在上述条件下,解压时只需将转换后的整数除以,即可准确恢复原始浮点值,实现无损转换。
对于无法满足上述条件的数据块,即或者的特殊数据直接进行十进制缩放可能无法保证无损恢复。因此,Falcon采用另一种二进制回退转换方案,如图4(b)所示。首先,直接读取浮点数底层的二进制位模式,并将其解释为64位整数,再进行第一次Zigzag编码,得到中间整数序列。随后,对相邻整数进行差分(Delta)计算,并进行第二次Zigzag编码,将差值转换为非负整数。两次Zigzag编码具有不同的作用:第一次用于调整原始二进制整数的表示,缓解不同符号浮点数之间的数值差异;第二次用于处理相邻整数的差值,使其更适合后续压缩。由于该方案直接保留浮点数的底层二进制信息,因此能够避免十进制缩放可能产生的精度损失,保证原始数据的无损恢复。
这种双路径设计使Falcon既能够提高普通浮点数据整数化后的可压缩性,又能够在特殊浮点数据情况下保证无损恢复。对于满足条件的普通浮点数据,通过十进制缩放提高整数表示的可压缩性;对于不满足条件的数据,则采用二进制回退方案保证无损恢复。同时,两种转换路径均结合差分和Zigzag编码,使相邻数据之间的变化更加集中,从而减少整数所需的编码位宽,为后续的自适应位平面编码提供基础。
2.2.3 自适应位平面编码
完成整数转换后,Falcon进一步利用整数数据中的位级特征进行压缩。由于异常值可能使整数表示范围扩大,进而拉长整个数据块所需的编码位宽,其余数值在较高位平面中往往会形成大量零字节,针对这一特点,Falcon首先构造bit-planematrix,并根据公共高位零信息裁剪实际需要的编码的位宽;随后对位平面矩阵进行转置,使同一位平面的数据连续排列。通过编码位平面,避免了由于位宽导致的字节不对齐问题。
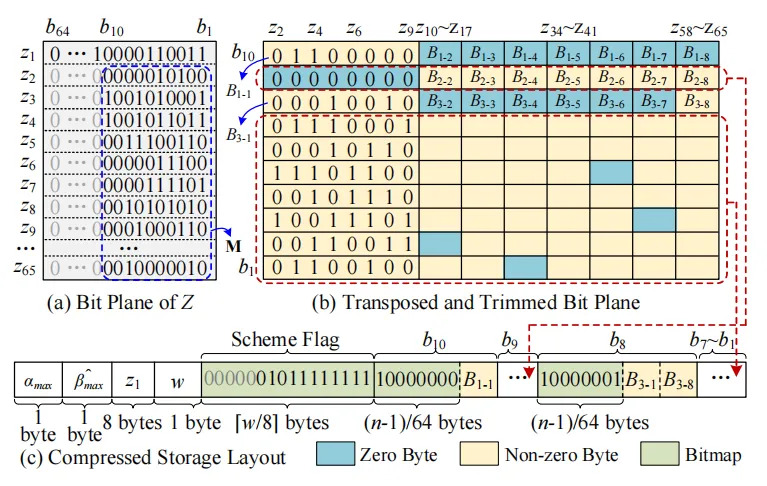
图5 自适应位平面编码
如图5所示,转置后的位平面中会出现大量zero byte,Falcon的关键设计在于:针对不同位平面的稀疏程度选择Sparsestorage或Densestorage。当某一位平面中包含大量零字节时,Falcon采用Sparsestorage,仅记录非零字节的位置和内容,从而减少存储开销;当零字节较少时,则采用Densestorage,直接保存完整数据,避免额外索引开销。
这种自适应策略主要用于缓解离群值导致的位宽扩张问题:当异常值拉长整个数据块的编码位宽时,其余数值在高位位平面中仍然会留下大量零字节,SparseStorage 可以充分利用这一特点。同时,由于零字节主要集中在前几个位平面中,线程执行分支较为一致,也能够减少GPU中的warp divergence问题。
三. 实验
3.1 实验设置
数据集:本文在13个浮点数据集上评估Falcon的性能,其中包括11个真实世界数据集和2个由TimeSeriesBenchmarkSuite(TSBS)生成的合成数据集。
对比方法:实验选取了10种先进压缩方法作为对比,包括CPU端浮点压缩算法Elf、ALP、Elf*,GPU端科学数据压缩算法ndzip,以及nvCOMP中的LZ4、Snappy、GDeflate、Bitcomp等通用GPU压缩方法,同时加入GElf*和G-ALP 两种GPU浮点压缩方法进行比较。
本文主要采用三个指标评价性能:
(1)压缩率(Compression Ratio):压缩后数据大小与原始数据大小的比例,数值越低表示压缩效果越好;
(2)压缩吞吐(Compression Throughput):单位时间内完成压缩的数据量;
(3)解压吞吐(Decompression Throughput):单位时间内完成解压的数据量。
3.2 整体性能比较
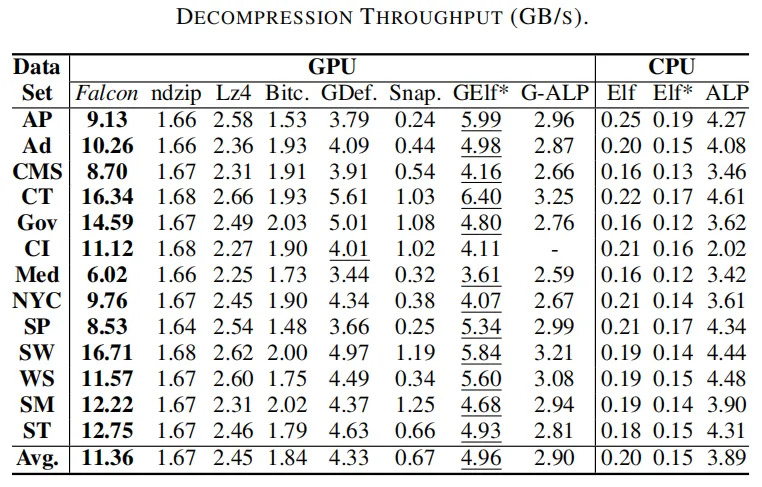
压缩率与吞吐全面领先:如表1、表2、表3所示,Falcon在压缩率、压缩吞吐和解压吞吐三个核心指标上均取得领先表现。具体而言,Falcon的平均压缩率达到0.373,相比CPU端浮点压缩方法 Elf、Elf* 和 ALP 分别提升22.3%、15.4%和10.6%;在压缩吞吐方面,Falcon平均达到10.65GB/s,相比GDeflate、ndzip和Bitcomp分别提升2.5×、5.5×和4.1×;在解压吞吐方面,Falcon平均达到11.36GB/s,相比GDeflate和ndzip分别提升2.6×和6.8×。
表1 不同方法压缩率比较
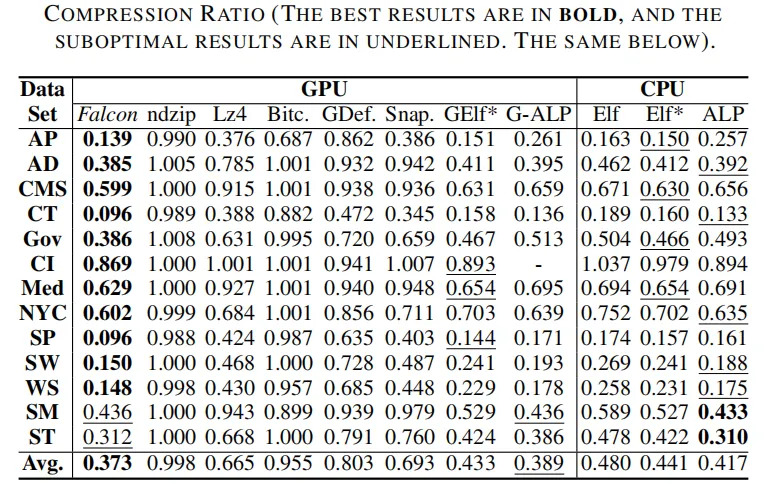
表2 不同方法压缩吞吐比较
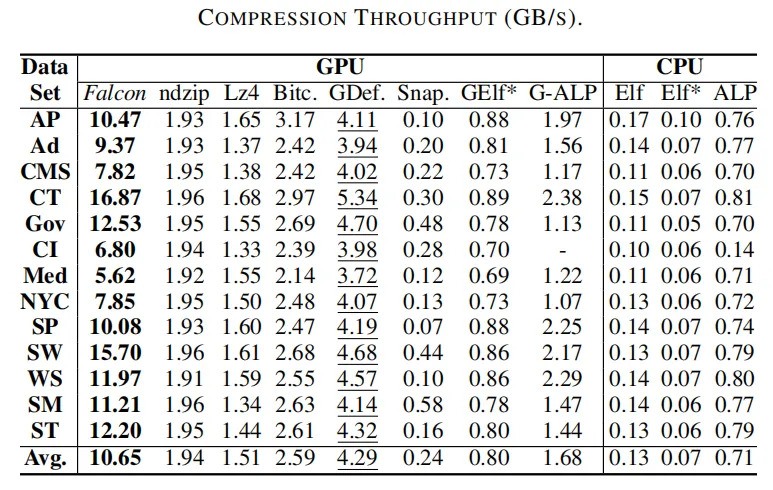
表3 不同方法解压吞吐比较
3.3 参数影响与可扩展性分析
不同数据精度下仍保持稳定领先:分析了浮点数据有效数字长度对Falcon性能的影响。如图6所示,随着有效数字长度增加,浮点数据精度提高,压缩难度也随之上升,因此各方法的压缩率和吞吐都会受到影响。但Falcon在不同精度设置下仍保持较优表现,说明其精确浮点转换和fallback机制能够有效适应不同精度的数据。
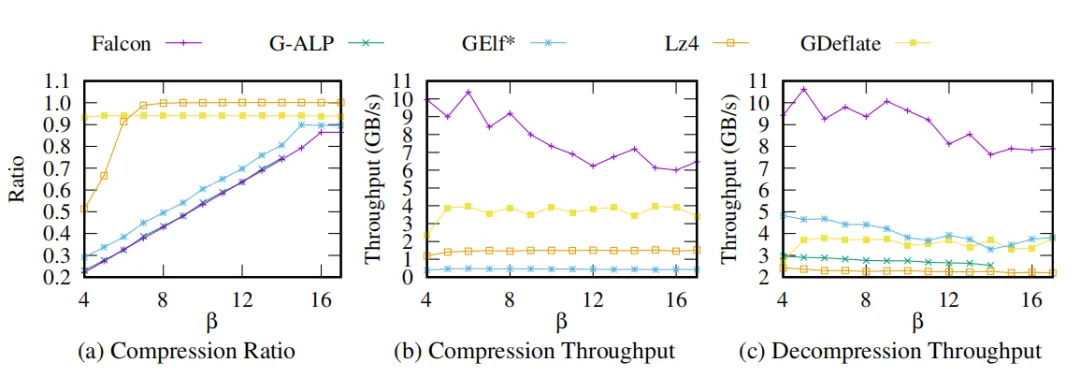
图6 不同decimalsignificand下的性能表现
此外,论文还验证了Falcon在不同数据规模和batchsize下的表现。结果显示,随着数据规模增大,Falcon的吞吐能力进一步提升;而合适的batchsize能够更充分利用GPU并行能力。
3.4消融实验
如图 7 所示,论文从流水线调度策略和算法组件两个角度进行了消融实验。
(1)比较三种流水线调度策略:
Event-DrivenScheduler在不同stream数量下均取得最高吞吐。
(2)分析算法组件的重要性:
比较了Falcon与三个算法变体:Fal.Elf、Fal.Sparse和Fal.Dense。其中,Fal.Elf 使用Elf中不够精确的小数位计算方式;Fal.Sparse将所有位平面都视为稀疏;Fal.Dense将所有位平面都视为稠密。实验结果显示,Falcon相比Fal.Elf在压缩率上提升约45%,吞吐提升超过1.5×;同时,自适应编码策略也优于固定sparse或dense的方案。
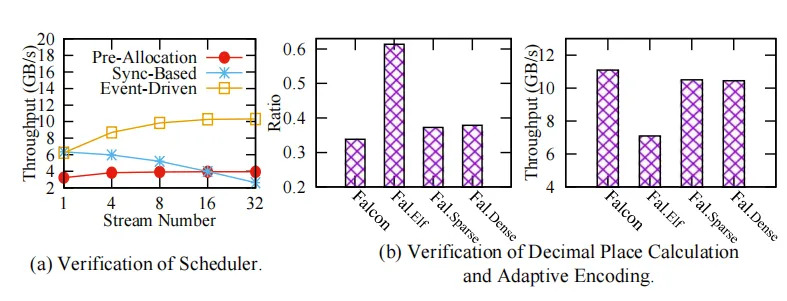
图7 消融实验
Falcon 的性能提升来自系统设计和算法设计的共同作用:事件驱动流水线提高了端到端吞吐,精确小数位计算保证了浮点转换的正确性,自适应位平面编码则进一步提升了压缩率并降低了数据传输开销。
四. 总结
本文提出了一种基于GPU的浮点数据自适应无损压缩框架Falcon。该方法针对CPU-GPU数据传输瓶颈、浮点转换误差以及异常值导致的压缩效率下降等问题,分别设计了异步流水线、精确浮点到整数转换方法和自适应稀疏位平面编码策略。Falcon在保证浮点数据无损恢复的同时,有效提升了压缩率和端到端处理效率,为大规模浮点数据管理提供了一种高性能GPU加速方案。
0 条评论